Delta Live Tables에서 CDC 처리: 브론즈, 실버, 골드 테이블 구현 시 dlt.apply_changes 활용 방법
apply_chages 메서드 탐구하기
소개
저는 데이터브릭스에서 raw 데이터를 수집할 때 AWS DMS 를 활용하고 있습니다.
AWS RDS 에서 생성된 binary log 를 기반으로 데이터 변경분과 관련된 parquet 파일을 S3에 생성합니다. 그리고 생성된 parquet 파일을 데이터브릭스에서 제공하는 autoloader 의 기능 중 directory listing mode 를 기반으로 CDC 처리를 진행하고 있습니다.
이때 bronze, silver, gold 테이블을 만들때 했던 고민을 같이 나누고자 합니다.
구현과정
데이터브릭스에서 제공하는 데이터 세트 형식 살펴보기
데이터 세트 형식 | 정의된 쿼리를 통해 레코드를 처리하는 방법 |
|---|---|
스트리밍 테이블 | 각 레코드는 정확히 한 번 처리됩니다. 이 경우 추가 전용 원본이 있다고 가정합니다. |
구체화된 보기 | 레코드는 현재 데이터 상태에 대한 정확한 결과를 반환하는 데 필요한 대로 처리됩니다. 구체화된 뷰는 변환, 집계 또는 느린 쿼리 및 자주 사용되는 계산 전 계산과 같은 데이터 처리 작업에 사용해야 합니다. |
뷰 | 레코드는 뷰를 쿼리할 때마다 처리됩니다. 공용 데이터 세트에 게시해서는 안 되는 중간 변환 및 데이터 품질 검사 보기를 사용합니다. |
스트리밍 테이블은 일반적으로 파이프라인의 ETL 단계에서 E(extract) 단계에서 가장 많이 사용합니다. 정확히 한 번 처리되어 원본 데이터로부터 지속적으로 CDC 데이터를 처리하는데 유리하기 때문입니다.
정확히 한 번 처리하는 동작방식이 CDC 데이터 처리하는데 유리한 이유
구체화된 보기(Materialized View, MView) 는 파이프라인의 ETL 단계에서 T(Transform) 단계에서 가장 많이 사용됩니다. 수집된 raw data 를 기준으로 연산을 가장 많이 하는 단계이기에 미리 연산 결과를 저장해서 사용하는 MView 가 더 유리합니다.
bronze 테이블 구현하기
kafka, DMS 등 여러 수집 포인트에서 Delta Table 을 구현하는 방식 링크 : https://github.com/databricks/delta-live-tables-notebooks.git
# Databricks notebook source
import dlt
from pyspark.sql.functions import *
from pyspark.sql.types import *

data = spark.conf.get('data')
tables = {
  'stores': {'id':'store_id'},
  'customers': {'id':'customer_id'},
  'products': {'id':'product_id'},
  'transactions': {'id':'transaction_id'}
}

def generate_tables(table, info):
  @dlt.table(
    name=f"{table}_cdc_raw",
    table_properties={ "quality": "bronze"},
    comment=f"Raw MySQL Data from DMS for the table: {table}",
    temporary=True
  )
  def create_call_table():
    stream = spark.readStream.format("cloudFiles")\
              .option("cloudFiles.format", "csv")\
              .option("cloudFiles.inferSchema", "true")\
              .option("cloudFiles.inferColumnTypes", "true")\
              .load(f"{data}/{table}")

    if 'Op' not in stream.columns:
      stream = stream.withColumn("Op", lit(None).cast(StringType()))

    return stream.withColumn("_ingest_file_name", input_file_name())

  dlt.create_streaming_live_table(
    name=f"{table}",
    comment="Silver(Merged) MySQL Data from DMS for the table: {table}"
    )

  dlt.apply_changes(
    target = f"{table}",
    source = f"{table}_cdc_raw",
    keys = [info['id']],
    sequence_by = col("dmsTimestamp"),
    apply_as_deletes = expr("Op = 'D'"),
    except_column_list = ["Op", "dmsTimestamp", "_rescued_data"],
    stored_as_scd_type = 2
  )

for table,info in tables.items():
  generate_tables(table,info)
위 코드는 데이터브릭스에서 AWS DMS 로 수집한 데이터를 스트리밍 테이블 형태의 Delta Table 로 만드는 코드입니다.
기본적인 원리는 아래와 같습니다.
S3 등에서 원본 데이터를 CDC 처리하지 않은 채로 수집하고 임시 테이블로 변환
CDC 처리를 한 데이터를 저장할 빈 스트리밍 데이터 생성
1번을 기준으로 CDC 처리를 한 이후, 2번에 저장
여기서 CDC 처리는 dlt.apply_changes 에서 이뤄집니다.
silver 테이블 생성시 고민점
저는 꾸준히 증가하고 있는 회원 테이블을 기준으로 여러 테이블과 조인하고, window 연산등을 통해 실버 테이블을 만들어야만 했습니다.이때 실버 테이블에 어떤 데이트 세트 형식을 적용해야 유리할지에 대한 고민이 많았습니다.
브론즈 회원 테이블은 다른 디멘션 테이블과 달리, 꾸준히 그 양이 증가하고 있기 때문에 그 특성을 잘 활용한 테이블을 만들어야만 했습니다.
스트리밍 테이블로 만든다면 window 나 그룹 연산을 사용할 경우 스트리밍 데이터의 특성상 매우 까다롭지만 회원 테이블은 주로 스트리밍 - 정적 테이블간의 조인이었기 때문에 워터마크 등의 제약사항을 많이 고려하지 않아도 되었습니다. 그러나 데이터 특성상 이너조인을 사용할 수 없었고 왼쪽 조인의 경우 스트리밍 데이터에서 굉장히 까다로웠습니다. 그래도 스트리밍 데이터에서 증분 데이터만 처리할 수 있다는 장점은 실버 테이블을 만들때 시간비용이 줄어들기에 시도할만한 가치는 존재했습니다.
구체화된 뷰로 만든다면 스트리밍 테이블로 만들었을때처럼 여러 제약사항이 존재하지 않아 빠르게 만들 수 있었습니다. 브론즈 테이블이 갱신되면 실버 테이블도 갱신할 때 그 비용이 스트리밍 테이블보다 컸습니다.
그래서 시간비용과 개발의 복잡함 중 어느 것을 택해야 좋을지 많은 고민을 했습니다.
스트리밍 테이블로 구현하기
아래와 같은 에러를 마주친 게 가장 큰 장벽이었습니다.
Flow 'user_silver' has FAILED fatally.
An error occurred because we detected an update or delete to one or more rows in the source table.
Streaming tables may only use append-only streaming sources.
If you expect to delete or update rows to the source table in the future,
please convert table user_silver to a live table instead of a streaming live table.
To resolve this issue, perform a Full Refresh to table user_silver.
A Full Refresh will attempt to clear all data from table user_silver and then load all data from the streaming source.

The non-append change can be found at version 11.
Operation: MERGE/
Username: doheekim
이 에러는 브론즈로 만든 스트리밍 테이블로 또다른 실버 스트리밍 테이블을 만들고자 했을때 발생했습니다. 간단하게 요약하면 스트리밍 테이블을 업스트림 테이블로 사용할 경우 데이터의 추가는 가능하나, 삭제 및 업데이트는 불가능하다는 것이었습니다.
이유는 브론즈 스트리밍 테이블이 dlt.apply_changes 의 결과물로 만들어진 스트리밍 테이블이라서 그랬습니다. apply_changes 로 생성된 테이블은, 내부적으로로는 raw 데이터셋 위에 view가 생성되어서 최신 데이터셋을 보여 주기 때문입니다.
dlt.apply_changes는 소스 데이터셋의 변경 사항을 캡처하여 타겟 테이블에 적용하는 함수입니다. 이 함수를 사용하여 생성된 브론즈 스트리밍 테이블은 실제로는 기본 데이터셋(raw dataset)에 대한 뷰(view)로 구현됩니다. 이 뷰는 항상 기본 데이터셋의 최신 상태를 반영하도록 설계되어 있습니다.
문제는 이렇게 생성된 브론즈 스트리밍 테이블을 업스트림 테이블로 사용하여 실버 스트리밍 테이블을 만들 때 발생합니다. 실버 테이블을 만들기 위해 브론즈 테이블에 대한 또 다른 뷰를 생성하려고 시도하는 것인데, 이는 뷰 위에 뷰를 겹쳐서 만드는 것과 같습니다.
이러한 뷰 위에 뷰를 겹치는 구조는 여러 가지 제한 사항을 가지고 있습니다. 가장 큰 제한 사항은 업데이트와 삭제 작업이 불가능하다는 것입니다. 뷰는 기본적으로 읽기 전용이므로, 뷰를 통해 데이터를 수정하거나 삭제할 수 없습니다. 따라서 브론즈 테이블이 이미 뷰로 구현되어 있기 때문에, 그 위에 실버 테이블의 뷰를 겹치면 업데이트와 삭제가 불가능해집니다.
이 문제를 해결하는 방법은 간단합니다. apply_changes 메서드를 실버 테이블에서 하도록 구현하면 됩니다.
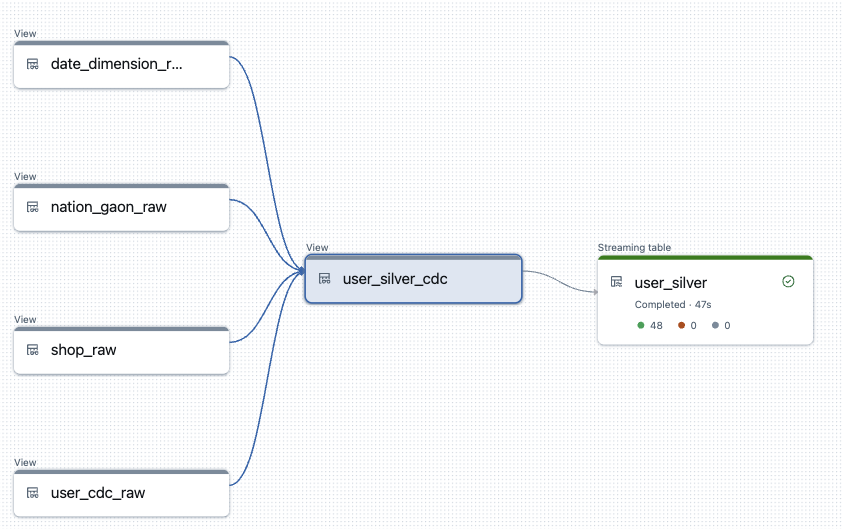
위 그림처럼 필요한 테이블을 view 혹은 임시테이블로 가져온 후, 조인이나 집계 연산을 진행합니다. 그 이후에 apply_changes 를 적용하면, 조인과 집계 연산의 결과물을 원래 원본 테이블에 존재하던 데이터 변경분처럼 활용할 수 있습니다.
MView 구현하기
느낀 점
데이터브릭스 내부에서 apply_changes 메서드가 작동하는 방법에 대해 알 수 있었음
브론즈 테이블을 가지고 실버 스트리밍 테이블을 만드는 방법에 대해 고민하고 구현할 수 있었음
이 경우, 브론즈 업스트림을 활용하지 못한다는 점이 매우 커서 MView 를 활용할 가능성이 큼
브론즈, 실버 테이블 각각 변경분과 원래 데이터를 가지고 증분 처리를 해야하므로 비용이 큼